Buffer Pools
Introduction
Section titled “Introduction”Problem #1
How the DBMS represents the database in files on disk.
行存储、列存储等等
Problem #2
How the DBMS manages its memory and move data back-and-forth from disk.
应该让 DBMS 直接管理,而不是让 OS 去直接管理
Spatial Control 空间管理
Section titled “Spatial Control 空间管理”- Where to write pages on disk.
- The goal is to keep pages that are used together often as physically close together as possible on disk. 让逻辑页面邻近的在物理上也邻近
Temporal Control 时序控制
Section titled “Temporal Control 时序控制”- 何时将页面读入内存,何时写入磁盘
- 目标是最小化从磁盘读取数据造成的阻塞
Buffer Pool Organization
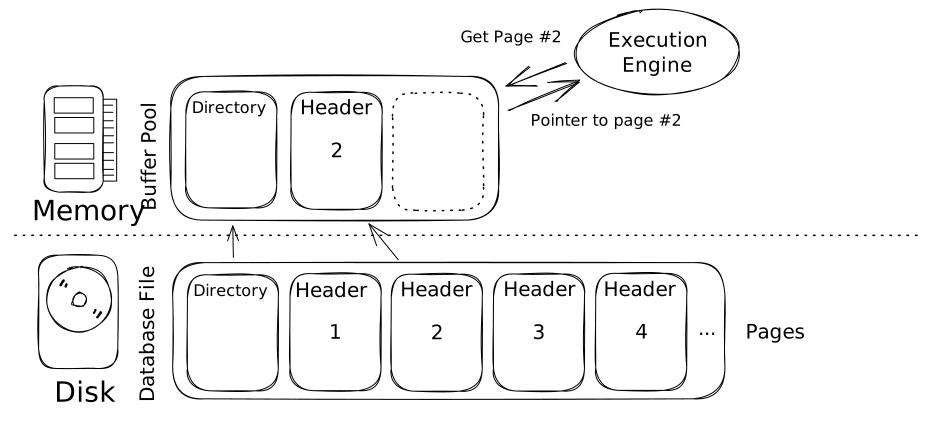
Section titled “Buffer Pool Organization”内存空间中划分出一些固定大小的页面,组成一个数组,每个数组的 entry 被称为一个 frame.
当 DBMS 请求读取某一页时,会从磁盘数据文件中拷贝一份到 buffer pool 中。
与此同时,需要为每个页面维护其元数据,保存在 page table 中,追踪在内存中的页面。
- Dirty page
- Pin/Reference Counter
多线程中,可能会有不同的线程同时访问页表,可能需要一些互斥锁来做一些保护措施。
Locks vs. Latches
Section titled “Locks vs. Latches”- 保护数据库的逻辑内容,不受其他事务的干扰
- 在事务期间内内保持所有权
- 需要有回退的功能
Latches
Section titled “Latches”- 保护 DBMS 内部数据结构的关键部分,不受其他县城的影响
- 在操作期间内保持所有权
- 无须拥有回退功能
Mutex
知乎的解释
- Latch 只作用于内存中,只能被当前实例访问,是瞬时占用的,是一个低级别的、轻量级的锁,获得和释放速度很快。不存在死锁。
- Lock 可能持续的时间很长,通过使用队列、按照先进先出的方式实现。Lock 作用于数据库对象,释放需要等待事务正确结束,占用的时长由事务大小决定。可能存在死锁。
Buffer Pool
Section titled “Buffer Pool”Page Table vs. Page Directory
Section titled “Page Table vs. Page Directory”Page directory 是将 page id 映射到 page location 对应的数据库文件(物理位置)
- 所有的修改必须记录在磁盘上,以便 DBMS 在重启的时候能再找到
Page table 是将 page id 映射到 buffer pool frame 中页面的拷贝
- 这是一种在内存上的操作,无需磁盘操作,是在 DBMS 运行时逐渐建立起来的
Allocation Policies
Section titled “Allocation Policies”Global Policies
Section titled “Global Policies”- Make decisions for all active transactions.
Local Policies
Section titled “Local Policies”- Allocate frames to a specific transaction without considering the behavior of concurrent transactions.
- Still need to support sharing pages.
Buffer Pool Optimizations
Section titled “Buffer Pool Optimizations”Multiple Buffer Pools
Section titled “Multiple Buffer Pools”DBMS 整个系统中不一定只有一个 buffer pool
- Multiple buffer pool instances
- Per-database buffer pool
- Per-page type buffer pool
Approach #1 Object Id
在 record ids 中嵌入一个对象的标识,维护一张从对象到指定的 buffer pool 的映射表
Approach #2 Hashing
创建页面 id 的 hash 值,来选择访问哪一个 buffer pool
Pre-fetching
Section titled “Pre-fetching”DBMS 可以根据 query plan,预先获取一些页面的数据。
- Sequential Scans
- Index Scans
Sequential Scans
Section titled “Sequential Scans”SELECT * FROM A WHERE val BETWEEN 100 AND 250;DBMS 按照满足空间局部性优化的方式,如果第一个页面被访问,那么可能会将第二个页面也预先存入 buffer pool 中。
Scan Sharing
Section titled “Scan Sharing”查询指针可以重复使用存储空间或者计算得到的数据,这可以将多个查询附加到单个 cursor 来扫描数据表。如果一个查询启动,且已经有一个扫描完成,那么 DBMS 会将其附加到第二个查询的 cursor 上。DBMS 追踪第二个查询和第一个查询连接的位置,在达到数据结构末尾时完成扫描。
Buffer Pool Bypass 缓冲池旁路
Section titled “Buffer Pool Bypass 缓冲池旁路”Sequential scan operator 不会将获取的页面存储在缓冲池中,以避免开销。内存对于正在运行的查询是局部的。如果 operator 需要读取磁盘上连续的大量页面,这种方式很有效。缓冲池旁路也可以用于临时数据(排序、连接)。
OS Page Cache
Section titled “OS Page Cache”大部分的磁盘操作都需要经过操作系统的接口。OS 将会维护它自己的文件系统缓存,除非特别指明。
大多数 DBMS 使用直接 I/O 来绕过操作系统缓存,以避免页面冗余副本,也避免了必须管理不同的换出策略。
Postgres 使用了操作系统页面的缓存。
Buffer Replacement Policies
Section titled “Buffer Replacement Policies”前面提到了缓存帧,当缓存已满时,需要使用一些换出策略。
类似操作系统中内存的换出策略
Least Recently Used (LRU)
Section titled “Least Recently Used (LRU)”维护一个最近访问的时间戳,这个时间戳可以存储在另外的空间,例如存储在一个队列当中。DBMS 在换出时,选择队列中时间戳最“老”的页面将其换出。
页面会按照时间戳排好序,以便减少换出时的排序时间开销。
时钟轮换策略相当于 LRU 策略中,不需要另外存储时间戳。在这种策略中,每个页面被赋予了一个“引用位”,如果这个页面被访问了,那么就会设置为 1.
如果可视化来看,那就是将页面缓冲区排成一个圈,有一个指针不断在这个圈中旋转。遇到一个页面,如果引用位为 1,那么将它设置为 0,转向下一个页面;如果引用位为 0,则将这个页面换出。
LRU 和 Clock 方式容易受到顺序泛洪的影响,其中缓冲池的内容由于顺序扫描而损坏。由于顺序扫描访问每个页面,因此读取的页面的时间戳可能无法反映我们实际需要的页面,即,最近使用的页面实际上是最不需要的页面。
针对这个问题,有三种解决方案
- LRU- 追踪最后 次访问的时间戳历史,计算页面访问之间的时间间隔。根据这一历史记录来预测将要访问的页面。
- 局部化每一次查询。DBMS 基于事务或查询来选择换出哪一页。这样可以最小化每次查询对于缓冲池的污染。
- 优先级提示允许事务根据查询执行期间每个页面的上下文,以确定缓冲池中的页面是否“重要”。
Dirty Pages
Section titled “Dirty Pages”有两种方式可以处理脏位。
- 快的方法:直接丢弃脏位无效的缓冲池页面
- 慢的方法:将标记脏位的页面写回到磁盘中,以保证数据的更改被持久化存储
避免两者之间权衡的方法是 background writing,这种方式下 DBMS 会定时扫描页表,将脏页写入到磁盘中。当脏页安全地写入完成后,DBMS 可以换出页面,也可以将脏位置为无效。
Other Memory Pools
Section titled “Other Memory Pools”DBMS 需要内存来存储 tuple 和 index,但也需要管理其他的内容。这些其他的 memory pools 可能并不会都备份到磁盘上,这是基于其实现来决定的。
- Sorting + Join Buffers
- Query Caches
- Maintenance Buffers
- Log Buffers
- Dictionary Caches