Tree Indexes
Table Indexes
Section titled “Table Indexes”数据库中可以使用非常多种数据结构
- Internal meta-data
- Core data storage
- Temporary data structures
- Table indexes(本章要讨论的)
A table index is a replica of a subset of a table’s columns that is organized and/or sorted for efficient access using a subset of those attributes.
不说人话的翻译:表索引是表列子集的副本,被组织和排序,以便使用这些属性的子集进行有效的访问。
DBMS 可以查找表索引的辅助数据结构来更快地找到目标元组,避免了顺序扫描。DBMS 确保表的内容和索引的内容在逻辑上总是同步的。
每个数据库要创建的索引数量之间存在权衡。虽然创建更多索引能够让查询更快,但是索引也会占用空间,同时需要维护。DBMS 的工作就包括了找到最适合查询命令的索引,按照这个索引来执行更高效的查询。
B+Tree
Section titled “B+Tree”B+ 树是一种自平衡的树数据结构,它能够保持数据有序,能够执行查找,顺序访问,插入,删除等操作,这些操作的时间复杂度都是 . 它对面向磁盘的 DBMS 进行大块数据读写进行了优化。
几乎所有支持保序索引的现代 DBMS 都使用 B+ 树。
B 树和 B+ 树最主要的区别是:
- B 树会在每个节点都存储数据
- B+ 树只在叶子节点存储数据
现代的 B+ 树实现结合了 B 树变体的一些特征,例如在 Blink 树中用到的兄弟指针。
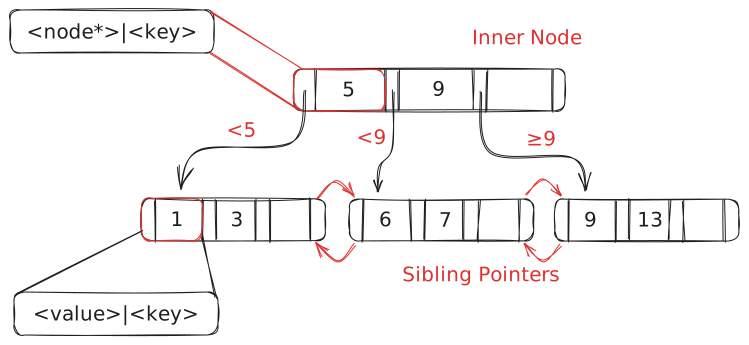
一般地,B+ 树是一种 路搜索树,具有以下性质
- 是一棵“完美”的平衡树(每个叶子节点都在同一深度)
- 除了根节点以外的内部节点至少都是半满的,
- 每个有 个键的内部节点都有 个非空的子节点
B+树的每个节点都包含了一个键值对的数组。
- 这些键值对中的键,派生自索引所基于的属性
- 值会根据该节点是内部节点还是叶子节点而区分
- 内部节点中,值数组包含的是指向其他节点的指针
- 叶子节点的值使用 record IDs 或 tuple data
- Record IDs 引用了元组地址的指针
- 使用 tuple data 直接存储实际的值
每个节点上的数组几乎总是按键来排序的,尽管根据 B+ 树的定义,这不是必须的。
Selection Conditions
Section titled “Selection Conditions”B+ 树是有序的,所以查询遍历速度是很快的,并不需要整个键。如果查询提供了搜索键的任意属性,DBMS 就可以使用 B+ 树索引。
树索引与哈希索引不同,哈希索引要求所有属性都包含在搜索键中
对于下面这样一棵 B+ 树,我们需要找到所有匹配 (A,*) 的元组
Insertion
Section titled “Insertion”将元素插入到 B+ 树时,必须从上到下遍历这棵树,使用内部节点来决定,应该将 key 插入到哪个叶子节点中。
- 找到正确的叶子节点
- 在 中有序插入一个 entry
- 如果 有足够的空间,那么直接插入
- 否则,将 拆分为两个节点 和 ,重新平均分配这些 entries,并复制中间的 key 到上层. 为 的父节点插入一个指向 的 index entry
- 如果需要分割内部节点,则将 entries 平均分配到两个节点中,并将中间结点上溢
Deletion
Section titled “Deletion”B+ 树的插入操作会使得节点分裂,以处理节点溢出。但如果删除节点导致了树达不到半满,那么就需要将部分节点合并,来保持树的平衡。
- 找到目标叶子节点
- 删除这个入口
- 如果 不少于半满,则直接删除
- 否则,尝试重新分配,可以从兄弟节点处借入
- 如果重新分配失败,则将 与兄弟节点合并
- 如果执行的合并操作,则必须将父节点中指向 的入口删除
Non-Unique Indexes
Section titled “Non-Unique Indexes”类似哈希表,B+ 树也可以处理重复的索引,手段是拷贝 key 或保存值列表。
- Duplicate keys approach: 使用相同的叶节点布局,但多次存储重复的键
- Value list approach: 每个键只存储一次,为唯一值维护一个链表
Duplicate Keys
Section titled “Duplicate Keys”复制键有两种方法
- 添加 record IDs 作为 key 的一部分,因为每个 tuple 的 record ID 都是唯一的,这将保证所有的键都是可识别的
- 允许叶子节点溢出到包含重复键的溢出节点中。虽然不存储冗余信息,但这种方法维护和修改起来比较复杂
Clustered Indexes 聚集索引
Section titled “Clustered Indexes 聚集索引”表按照主键指定的排序顺序存储,作为堆组织存储或索引组织存储。由于一些 DBMS 总是使用聚集索引,因此如果表没有显式索引,它们将自动将隐藏的行 ID 设置为主键,但其他 DBMS 不能使用。
Heap Clustering 堆聚集
Section titled “Heap Clustering 堆聚集”元组在堆的页面中按照聚集索引指定的顺序排序。如果使用聚集索引的属性访问元组,DBMS 可以直接跳转到对应的页面。
Index Scan Page Sorting
Section titled “Index Scan Page Sorting”由于直接从未聚类的索引中检索元组的效率很低,因此 DBMS 可以首先找出它需要的所有元组,然后根据它们的页面 ID 对它们进行排序。
B+Tree Design Choices
Section titled “B+Tree Design Choices”Node Size
Section titled “Node Size”根据存储媒介,我们可以指定节点大小。
- 对于硬盘数据库上的节点,通常是以 MB 为单位,为的是减少寻找的开销,将磁盘读取用于大块数据上
- 对于内存数据库中的节点,通常使用 512 B 的页面,以便将整个页面放入 CPU 缓存中,并减少数据碎片
这还是取决于工作负载的类型。
- 单点查询希望页面尽可能小,以减少加载不必要的额外信息
- 大型顺序扫描可能希望页面更大,以减少需要执行的读取次数
Merge Threshold
Section titled “Merge Threshold”虽然 B+ 树有删除后合并下溢节点的规则,但有时暂时违反这种规则以减少删除操作的数量可能是有益的。
急于合并可能导致“震荡”,其中大量连续的删除和插入操作导致不断的拆分和合并。
允许批处理合并,多个合并操作同时发生,减少了在 B+ 树上写锁存器的巨大开销。
Variable Length Keys 变长的键
Section titled “Variable Length Keys 变长的键”我们可能也想 B+ 树支持变长的关键字长度,例如大键的一小部分会造成很多的空间浪费。有下面的一些解决方案
Pointers
Section titled “Pointers”我们可以只存储指向 key 的指针,而不是直接存储这个 key. 因为为每个键追踪一个指针效率很低,在生产环境中唯一使用这种方法的地方是嵌入式设备,其它们的寄存器和缓存都很小,可以从中得到一些益处。
Variable Length Nodes
Section titled “Variable Length Nodes”我们仍然可以正常存储键,允许使用变长的节点。但这是不太可行的,由于处理可变长度节点的内存管理开销很大,所以大部分情况下都不会使用这种方法。
Padding
Section titled “Padding”我们可以讲每个键的大小设置为最大键的大小,并填充所有较短的键,而不是改变键的长度。大多数情况下,这是对内存的极大浪费,所以用的也不多。
Key Map/Indirection
Section titled “Key Map/Indirection”最常用的方法就是在单独的字典中用键值对的索引替换键,这大大节省了空间,并可能为单点查询提供了快捷方式(因为索引指向的键值对与叶节点指向的键值对完全相同)。
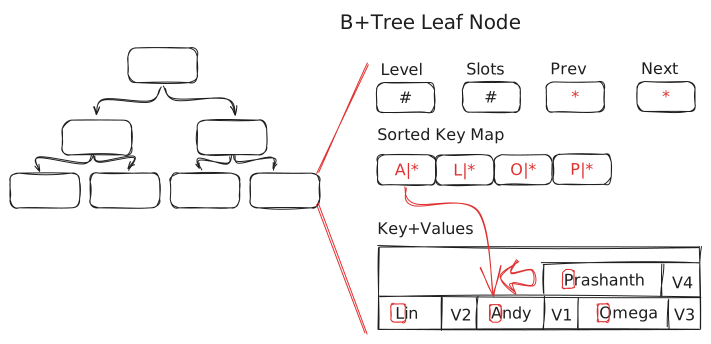
在 map 中存储了一小部分 key 的前缀,以及指向 k-v 对的指针。
Intra-Node Search 内部节点的搜索
Section titled “Intra-Node Search 内部节点的搜索”当搜索达到了某个节点之后,仍然需要继续在节点内进行搜索,目的是找到下一个内部节点,或者是找到叶子节点中的 k-v 对。虽然这种事情非常简单,但还是有一些要考虑权衡的问题。
Linear 线性搜索
Section titled “Linear 线性搜索”最简单的方法,在节点中直接顺序扫描,直至找到结果。一方面,我们无须考虑对键进行排序,也无须考虑插入和删除的优化,但是另一方面,这种方式相比之下是比较低效的,每次搜索的时间复杂度都是 .
Binary 二分搜索
Section titled “Binary 二分搜索”相比于上面的顺序搜索,效率更高一些,因为使用了二分查找,依据已经排序的 key,时间复杂度是 ,但是插入操作开销就会变大一些,因为需要维护节点内的这些 key 的有序性。
Interpolation 插值查找
Section titled “Interpolation 插值查找”在某些情况下,我们可能需要使用插值来找到对应的键。这种方式利用了节点中存储的 metadata,例如最大元素,最小元素,平均值等等,利用这些属性来生成一个键大概的位置。
例如,我们要在节点中找到 8,而 10 是最大的 key, 是最小的 key,那么可以从最后一个键向前数 2 个。( 为每个节点的键数量)
尽管这种方式是很快的,但它的适用性可能仅限于例如整数的属性,而且很复杂,因此只在学术数据库中使用这种方法。
Optimization
Section titled “Optimization”Prefix Compression
Section titled “Prefix Compression”大多数情况下,如果在 B+ 数的同一个节点上有键时,每个键的前缀会有部分重叠,因为相似的键会在排序的 B+ 数中彼此相邻。
按照这一特征,我们可以对这种存储方式进行优化,不需要每个键都全部存储,相同前缀只需存储一次,将不相同的部分分开存储(类似于字典树)